一封提到你上週去哪裡、抱怨過哪家客服、養了什麼寵物的郵件,你會起疑嗎?德州大學阿靈頓分校與路易斯安那州立大學的研究團隊,用 200 個公開 Instagram 帳號的貼文生成近 1.8 萬封釣魚郵件,再請 70 位受試者評分。結果是:這些 AI 寫的詐騙信,在受試者眼中的可疑程度不只低於真實詐騙郵件,甚至低於混在其中的正常郵件。
重點摘要
- 可疑度評分分數越高越可疑。看真實詐騙郵件的那組,詐騙信 4.44、正常郵件 2.83,分得出來
- 看 AI 生成郵件的那組,詐騙信 2.75、正常郵件 3.11,詐騙信反而被評為更不可疑
- 攻擊者只需 10 至 15 則公開貼文,每封郵件成本約 0.002 至 0.004 美元
- 論文的防護建議針對平台與 AI 業者,個人能做的是減少可用素材與改變驗證習慣
AI 詐騙信比正常郵件看起來更可信
研究在使用者研究中混入了惡意郵件與正常郵件,請受試者為可疑程度評分(分數越高越可疑)。結果分成兩組看:
- 看 APWG 真實詐騙郵件的那組:惡意郵件 4.44 分、正常郵件 2.83 分,兩者差距 1.61 分。受試者分得出來。
- 看 AI 生成郵件的那組:惡意郵件 2.75 分、正常郵件 3.11 分,差距為 負 0.36 分。受試者反而覺得詐騙信比正常郵件更可信。
論文以 Kruskal-Wallis 檢定比較兩組的落差,結果具統計顯著性(H=26.22,p 小於 10 的負 6 次方)。需要說明的是,這項檢定證明的是「兩組的分辨能力有顯著差異」,而非「負 0.36 分本身顯著小於零」。但方向已經很清楚:面對真實詐騙郵件,受試者的直覺有效;面對 AI 生成的郵件,這套直覺不再提供保護。
你的貼文為詐騙提供素材
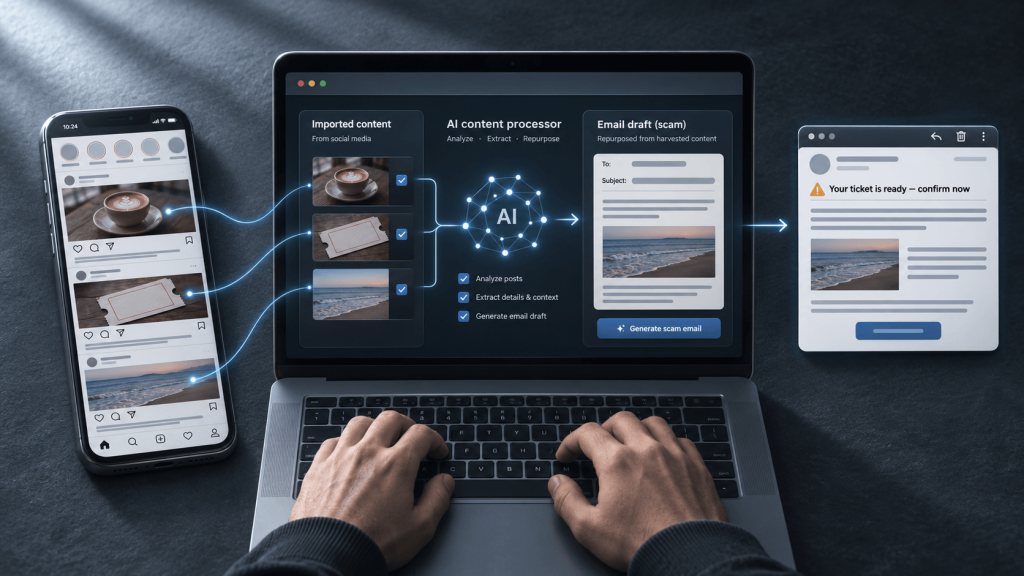
研究從 CrowdTangle 取得的一萬個公開帳號中隨機抽出 200 個,收集 2023 年 6 月 24 日至 2024 年 6 月 24 日間的貼文,每個帳號最多 20 則,總計 3,268 則。團隊用 GPT-4o 讀取貼文的文字與圖片內容。請注意是圖片內容——不只是你打的字,照片裡出現的場景、招牌、票根、商品,都是可讀取的資訊。
擷取出來的素材被用來生成七種社交工程類型的郵件:誘餌、恐嚇軟體、蜜糖陷阱、尾隨、冒充、利益交換,以及情緒利用。五個模型共生成 17,916 封,分別為 Gemma 5,045 封、Llama 4,855 封、Claude 3,959 封、GPT-4 2,634 封、Gemini 1,423 封。
依論文說明,輸出階段會一併產生郵件主旨與看似合理的寄件者身分。換句話說,整封郵件的脈絡是一致的,「措辭怪異、稱呼錯誤」這類傳統警訊不會出現。
十五則貼文就夠了
這是對一般使用者最不利的一項發現:攻擊者不需要長期蹲點。
研究以實體熵衡量每則貼文帶來的新資訊,發現在第 1 到 3 則貼文之間快速上升,第 5 則之後趨於平緩。作者的結論是 10 至 15 則貼文即足以提供充分脈絡,其中下限來自收斂趨勢,上限則是為貼文較少的帳號保留的餘裕。
成本方面,論文依 GPT-4o 的 API 定價估算,每封郵件約 0.002 至 0.004 美元,耗時數秒。過去定向釣魚「要花時間逐一研究目標」的天然限制,在工具層面已經不存在。
人人可以保護自己的七件事
需要先說明:論文本身的防護建議是寫給平台與 AI 業者的,並未針對一般使用者提供清單。以下是依研究揭露的攻擊機制、對照一般資安實務整理出的做法,取材的是「AI 需要什麼素材」與「什麼警訊已失效」這兩點,並非論文的結論。
-
行程貼文延後發
出遊、看演唱會、出差的貼文等回家後再發。即時的地點與日期是最容易被組裝成「訂單異常」、「行程變更」誘餌的素材。
-
貼文改成非公開
研究用的是一年內的貼文。把帳號改為非公開,並檢查早期貼文的可見範圍——很多人的隱私設定是後來才調整的,之前的內容仍然公開。
-
注意照片透漏了哪些資訊
AI 讀的是圖片內容。票根上的場次、收據上的店名、工作證上的單位、包裹上的地址,都在截圖與合照裡出現得比想像中頻繁。
-
情緒與健康內容最容易被利用
七種攻擊類型中有一類專做情緒利用。抱怨某家客服、提到身體不適、分享家人狀況,都是高價值素材,因為它們直接提供了可被利用的情境。
-
一律用官方公開的聯絡方式查證
既然內容已不能作為判斷依據,能依靠的只剩管道。遇到退款、優惠、帳號異常,一律不點郵件裡的連結,改用官方 App 或自己查到的電話確認。
-
信箱一定要開雙因素
電子郵件帳號是其他帳號的復原管道,一旦被接管,攻擊範圍會迅速擴大。這是優先度最高的一項設定。
-
改用密碼管理器與通行密鑰
密碼管理器只在正確網域自動填入,通行密鑰則無法被轉述到假網站。即使真的被誘導到仿冒頁面,登入資料也不容易外洩。
護欄目前攔不住
研究測試了三款現成的 AI 安全護欄,用 1,750 則惡意提示詞進行。預設設定下的偵測率為:Llama Guard 3 8B 為 0%、ShieldGemma 2B 為 12.1%、WildGuard 7B 為 19.2%。
加入明確的政策說明後大幅改善,三者分別達到 92.7%、84.3%、96.0%;再加上思考鏈提示,WildGuard 升至 98.7%,但另兩款反而下降至 82.5% 與 69.0%。換句話說,改善方法有效,但並非對每個模型都一致適用。研究團隊另訓練了一個 RoBERTa 分類器,在提示詞層級達到 98.13% 準確率、100% 精確率、96% 召回率。
這些都是模型方的設定,使用者無法自行檢查或開啟。這也是不宜把防護責任放在護欄上的原因。
本文的查核說明
本文所引用的樣本數、評分、統計檢定值與護欄數據,均以 arXiv 論文全文逐項核對。有兩點需要向讀者說明:
- 部分報導寫「偵測率提升至 99%」,論文的最高數字為 98.7%。同一報導引用的「0% 至 19%」則與論文一致。
- 部分報導提到論文將於 2027 年 3 月的資安會議發表。arXiv 頁面並無會議標註,我們也未能從可靠來源確認,因此本文不採用發表時程的說法。
研究倫理方面,論文載明使用者研究通過研究倫理委員會(IRB)審查,資料僅取自公開帳號,且明確表示未寄出或散布任何生成的郵件。範圍上,資料來源僅限 Instagram、時間窗口為一年,樣本中有半數帳號的公開貼文不足 20 則。
常見問題
改成非公開就安全了嗎?
能大幅減少素材來源,但不等於安全。朋友的公開合照、標註、公司官網的團隊介紹與活動照片,同樣可以提供情境。這是降低風險,不是消除風險。
郵件提到我的私事,不就代表是認識的人嗎?
不代表。這正是研究要說明的重點:這些細節並非捏造,而是從你自己公開分享過的內容蒐集而來。郵件知道你的事,從此不再構成寄件者可信的理由。
我完全不發文的話呢?
研究針對的是公開社群貼文,但同樣的手法可以套用在任何公開資訊上。對一般人來說,比「完全不發」更實際的是控制可見範圍,並把驗證習慣建立起來。
收到了可疑郵件該怎麼辦?
不要點連結、不要回信、不要下載附件。用官方 App 或自己查到的電話確認狀況。若已經輸入過密碼,立刻從別的裝置更改該密碼,並檢查信箱的轉寄規則是否被動過。
直覺已經不管用了
我們辨識詐騙郵件的直覺,大多建立在「寫得很爛」這個前提上:語句不順、稱呼錯誤、內容與自己無關。這份研究最值得記住的一點,是這個前提已經失效——在實驗中,受試者甚至覺得 AI 詐騙信比正常郵件更可信。
當郵件的內容不再能作為判斷依據時,能夠依靠的只剩兩件事:你公開給世界的素材有多少,以及你願不願意在點下去之前,換一個管道確認。這兩件事都不需要等平台或 AI 業者修好護欄,現在就可以開始做。
優吉兒網頁設計持續關注 AI 與網頁技術的最新發展,並致力於落實在專案中,讓您的網站與世界接軌。若您正在規劃公司網站或改版升級,歡迎了解我們的網站作品與網站開發服務,或直接聯絡我們,我們提供免費的線上諮詢。
本文初稿由 AI 協助編寫